
क्या AI सच में इंसानों की तरह सोचता है?
Artificial Intelligence kaise sikhta hai, यह सवाल आज हर उस इंसान के मन में आता है जो तकनीक से जुड़ा है। आज Artificial Intelligence हमारे जीवन का ऐसा हिस्सा बन चुका है, जिसे नजरअंदाज करना मुश्किल है। मोबाइल का face unlock, YouTube की recommendations, Google Maps का traffic अनुमान, online shopping suggestions और ChatGPT जैसे conversational tools—इन सबके पीछे अलग-अलग रूपों में AI काम कर रहा है।
लेकिन एक सवाल अक्सर लोगों के मन में आता है—AI आखिर सीखता कैसे है?
क्या मशीन को किताबें पढ़ाई जाती हैं? क्या कोई इंसान उसे हर सवाल का जवाब सिखाता है? या फिर AI खुद इंटरनेट पर बैठकर ज्ञान इकट्ठा करता रहता है?
सच्चाई इन धारणाओं से थोड़ी अलग और कहीं अधिक रोचक है। AI इंसानों की तरह स्कूल नहीं जाता, न ही उसके पास बचपन की यादें होती हैं। वह अनुभव को भी इंसान की तरह महसूस नहीं करता। आधुनिक AI मुख्य रूप से डेटा में मौजूद patterns को पहचानकर, अपनी गलतियों को मापकर और बार-बार अपने गणितीय parameters को बदलकर सीखता है।
यही प्रक्रिया आज की AI revolution की बुनियाद है।
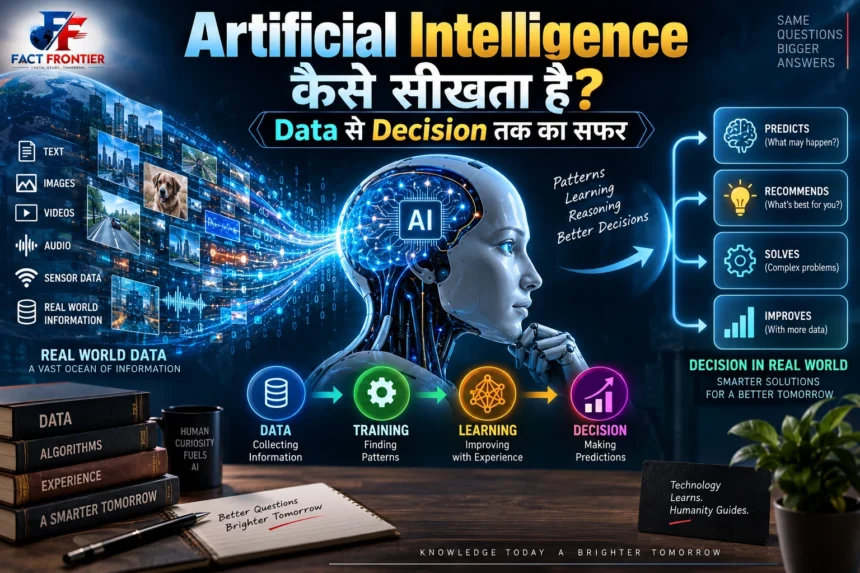
सीखने की शुरुआत डेटा से होती है
किसी भी AI system के लिए data लगभग वैसा ही है जैसा इंसान के लिए अनुभव और जानकारी।
मान लीजिए हमें एक AI system बनाना है जो बिल्लियों और कुत्तों की तस्वीरों में अंतर कर सके। इसके लिए कंप्यूटर को हजारों या लाखों छवियों दी जा सकती हैं। कुछ images में cats होंगी और कुछ में dogs।
AI इन तस्वीरों को इंसान की तरह देखकर नहीं समझता कि यह जानवर प्यारा है या इसका रंग सुंदर है। उसके लिए image मूल रूप से numbers का एक विशाल समूह होता है।
धीरे-धीरे model यह पहचानना शुरू करता है कि कुछ visual patterns बार-बार cats से जुड़े दिखाई देते हैं और कुछ dogs से।
शुरुआत में उसकी predictions गलत हो सकती हैं। वह cat को dog और dog को cat बता सकता है। लेकिन training के दौरान उसे बताया जाता है कि उसकी prediction सही थी या गलत।
फिर model अपने अंदर मौजूद गणितीय settings में छोटे बदलाव करता है।
यही प्रक्रिया हजारों और लाखों बार दोहराई जाती है।
धीरे-धीरे AI की accuracy बेहतर हो सकती है।
AI की learning का मूल सिद्धांत यही है—prediction, error और correction।
Machine Learning क्या है?
Artificial Intelligence एक बहुत बड़ा क्षेत्र है। इसके अंदर कई अलग-अलग technologies आती हैं। इनमें सबसे महत्वपूर्ण क्षेत्र है Machine Learning।
Traditional computer programming में इंसान पहले rules लिखता है।
उदाहरण के लिए:
अगर temperature 40 degrees से ऊपर है, तो “बहुत गर्म” दिखाओ।
यहां computer खुद कुछ नहीं सीख रहा है। वह केवल दिए गए नियम का पालन कर रहा है।
Machine Learning में तरीका अलग होता है।
यहां हर नियम पहले से लिखना जरूरी नहीं होता। इसके बजाय machine को examples दिए जाते हैं।
मान लीजिए हजारों घरों की जानकारी AI को दी जाती है—जैसे उनका size, location, rooms और कीमत। Model इन उदाहरणों में patterns खोजने की कोशिश करता है।
बाद में किसी नए घर की जानकारी मिलने पर वह उसकी संभावित कीमत का अनुमान लगा सकता है।
इसका मतलब यह नहीं है कि मशीन को घरों की वास्तविक समझ हो गई है। उसने बस data में मौजूद statistical relationships से अनुमान लगाना सीखा है।
यहीं एक महत्वपूर्ण बात समझनी चाहिए—AI अक्सर “जानता” कम है और patterns के आधार पर “अनुमान” अधिक लगाता है।
Neural Networks: AI के सीखने का गणितीय ढांचा
आधुनिक AI के पीछे अक्सर Artificial Neural Networks का इस्तेमाल होता है।
इनका नाम मानव मस्तिष्क के neurons से प्रेरित है, लेकिन दोनों को एक जैसा मानना गलत होगा।
मानव मस्तिष्क अरबों biological neurons से बना एक अत्यंत जटिल जीवित तंत्र है। दूसरी ओर, Artificial Neural Network एक mathematical system है।
इसमें कई artificial units होते हैं जो numbers पर calculations करते हैं।
एक network को कई layers में बांटा जा सकता है। शुरुआती layers साधारण patterns पकड़ सकती हैं, जबकि आगे की layers अधिक जटिल relationships को process करती हैं।
उदाहरण के लिए image recognition में शुरुआती स्तर पर edges और simple shapes जैसे patterns पहचाने जा सकते हैं। आगे की processing में अधिक जटिल visual features सामने आ सकते हैं।
Neural network के भीतर बड़ी संख्या में parameters होते हैं।
इन्हें आप मशीन के adjustable mathematical controls की तरह समझ सकते हैं।
Training का एक बड़ा हिस्सा इन्हीं parameters को बदलने में जाता है।
गलती AI की सबसे बड़ी शिक्षक होती है
AI की training को समझने के लिए एक छात्र की कल्पना कीजिए जो गणित का सवाल हल कर रहा है।
पहले प्रयास में उसका उत्तर गलत आता है।
फिर शिक्षक बताता है कि गलती कहां हुई।
छात्र अगली बार अपना तरीका बदलता है।
AI में भी कुछ ऐसा ही होता है, हालांकि पूरी प्रक्रिया mathematics के माध्यम से चलती है।
मान लीजिए model ने किसी तस्वीर को dog बताया, जबकि सही उत्तर cat था।
System prediction और वास्तविक उत्तर के बीच अंतर को मापता है। इस अंतर को सामान्य रूप से loss या error कहा जाता है।
अब training algorithm यह पता लगाने की कोशिश करता है कि parameters में किस दिशा में बदलाव करने से error कम हो सकता है।
छोटे-छोटे बदलाव किए जाते हैं।
फिर model दोबारा prediction करता है।
यह प्रक्रिया बार-बार चलती है।
हजारों, लाखों और कभी-कभी अरबों training examples के बाद model कुछ patterns को बेहतर तरीके से पकड़ने लगता है।
AI अचानक बुद्धिमान नहीं बनता।
उसकी क्षमता आम तौर पर असंख्य छोटे mathematical adjustments का परिणाम होती है।
Deep Learning ने AI को क्यों बदल दिया?
Machine Learning के भीतर एक महत्वपूर्ण क्षेत्र है—Deep Learning।
Deep Learning में बड़े और कई layers वाले neural networks का उपयोग किया जाता है। पिछले दशक में computing power, बड़े datasets और बेहतर algorithms के कारण Deep Learning में तेज प्रगति हुई।
इसी तकनीक ने image recognition, speech recognition और language processing में बड़े बदलाव किए।
जब आप किसी phone से कहते हैं, “आज मौसम कैसा है?” और device आपकी आवाज़ को text में बदलकर जवाब देता है, तो इसके पीछे कई AI systems एक साथ काम कर सकते हैं।
एक system आवाज को पहचानता है।
दूसरी भाषा को प्रोसेस करता है।
तीसरा आपके सवाल का अर्थ निकालने की कोशिश करता है।
फिर कोई system जवाब तैयार करता है।
आज के AI models में यह पूरी प्रक्रिया पहले की तुलना में कहीं अधिक integrated हो चुकी है।
ChatGPT जैसी AI भाषा कैसे सीखते हैं?
यह सवाल सबसे रोचक है।
ChatGPT जैसे Large Language Models, या LLMs, भाषा को इंसानों की तरह व्याकरण की किताब पढ़कर नहीं सीखते।
उन्हें बहुत बड़ी मात्रा में text-based data पर train किया जाता है।
Training के दौरान model बार-बार यह सीखने की कोशिश करता है कि किसी sequence के बाद कौन-सा शब्द या token आने की संभावना है।
उदाहरण के लिए:
“भारत की राजधानी…”
इसके बाद “नई दिल्ली” आने की संभावना बहुत अधिक होगी।
लेकिन आधुनिक language models की प्रक्रिया केवल एक शब्द की dictionary prediction से कहीं अधिक जटिल होती है।
वे वाक्य के context, शब्दों के बीच संबंध और भाषा के statistical patterns को mathematical रूप में represent करना सीखते हैं।
यही कारण है कि एक आधुनिक LLM कविता लिख सकता है, code तैयार कर सकता है, किसी विषय को समझा सकता है और कई भाषाओं में बातचीत कर सकता है।
फिर भी यह समझना जरूरी है कि fluent भाषा लिखना और इंसान की तरह दुनिया को समझना एक ही बात नहीं है।
Transformer क्या है और इसकी भूमिका क्यों महत्वपूर्ण है?
आज के कई powerful language models की सफलता में Transformer architecture की महत्वपूर्ण भूमिका रही है।
Transformer-based systems language के अलग-अलग हिस्सों के बीच संबंधों को प्रभावी तरीके से process कर सकते हैं।
मान लीजिए एक लंबे वाक्य में किसी शब्द का अर्थ समझने के लिए वाक्य के बहुत पहले आए शब्द को देखना जरूरी हो।
पुराने systems के लिए लंबे context को संभालना कठिन हो सकता था।
Transformers ने context और relationships को process करने के तरीके में महत्वपूर्ण बदलाव किया।
इस architecture के साथ बड़े datasets और शक्तिशाली computing infrastructure का उपयोग किया गया। परिणामस्वरूप language models की क्षमता तेजी से बढ़ी।
यही कारण है कि आज AI केवल छोटे commands पर प्रतिक्रिया देने तक सीमित नहीं है। वह लंबे documents को summarize कर सकता है, कई भाषाओं में जवाब दे सकता है और जटिल instructions को संभाल सकता है।
Supervised Learning: जब AI को सही जवाब पता होता है
Machine Learning का एक प्रमुख तरीका है Supervised Learning।
इसमें training data के साथ सही answer या label भी दिया जाता है।
जैसे:
यह image = Cat
यह image = Dog
यह email = Spam
यह email = Not Spam
Model इन examples से patterns सीखता है।
यह तरीका image classification, medical data analysis और spam detection जैसी applications में उपयोगी हो सकता है।
लेकिन हर data के साथ इंसान द्वारा label लगाना आसान नहीं है।
इंटरनेट पर मौजूद अरबों text documents को बैठकर कोई व्यक्ति manually classify नहीं कर सकता।
यहीं दूसरी training techniques महत्वपूर्ण हो जाती हैं।
Self-Supervised Learning: जब डेटा खुद शिक्षक बन जाता है
आधुनिक Generative AI की प्रगति में self-supervised learning की बड़ी भूमिका है।
इसमें हर example के लिए अलग-अलग इंसान से answer लिखवाना जरूरी नहीं होता।
Language data स्वयं learning task तैयार करने में मदद कर सकता है।
उदाहरण के लिए किसी sentence का एक हिस्सा छिपाकर model से prediction करने को कहा जा सकता है।
इस model को text sequence का अगला हिस्सा predict करना सिखाया जा सकता है।
इस तरह विशाल मात्रा में उपलब्ध text से learning संभव होती है।
इसी वजह से आधुनिक language models इतने बड़े datasets पर train किए जा सकते हैं।
हालांकि data की quantity के साथ उसकी quality भी महत्वपूर्ण है। गलत, biased या low-quality data model के behaviour को प्रभावित कर सकता है।
आज AI research में data curation, filtering और deduplication पर विशेष ध्यान दिया जा रहा है। Stanford HAI के 2026 AI Index में भी data quality और post-training techniques के बढ़ते महत्व को रेखांकित किया गया है। (Stanford HAI)
Reinforcement Learning: सही जवाब को बेहतर बनाना
AI learning का एक और तरीका है Reinforcement Learning।
इसे एक सरल उदाहरण से समझा जा सकता है।
मान लीजिए कोई system किसी काम को करने के कई तरीके आजमाता है। अच्छे परिणाम पर उसे reward मिलता है और खराब परिणाम पर कम reward।
समय के साथ system ऐसे decisions को प्राथमिकता देना सीख सकता है जिनसे बेहतर परिणाम मिलने की संभावना अधिक हो।
Modern AI systems में reinforcement learning और human feedback जैसी techniques का उपयोग model के behaviour को बेहतर बनाने में किया जाता है।
मानव evaluators model के अलग-अलग answers का मूल्यांकन कर सकते हैं। इस feedback की मदद से model को अधिक उपयोगी, सुरक्षित और निर्देशों के अनुरूप बनाने का प्रयास किया जाता है।
लेकिन यहां भी एक सीमा है।
Human feedback AI को हर परिस्थिति में सही नहीं बना सकता।
वह गलत जानकारी दे सकता है।
कभी-कभी वह बहुत आत्मविश्वास के साथ गलत उत्तर भी प्रस्तुत कर सकता है।
Training और Inference में क्या अंतर है?
AI के काम को समझने के लिए यह अंतर महत्वपूर्ण है।
Training वह चरण है जिसमें model data से patterns सीखता है और उसके parameters को adjust किया जाता है।
यह प्रक्रिया computationally बहुत भारी हो सकती है।
इसके बाद आता है Inference।
Inference वह चरण है जब trained model किसी नए सवाल, image या input पर अपना उत्तर तैयार करता है।
जब आप chatbot से पूछते हैं, “भारत का सबसे बड़ा राज्य कौन-सा है?” तब सामान्य रूप से model दोबारा अपनी पूरी training नहीं कर रहा होता है।
वह पहले से सीखे हुए mathematical patterns का उपयोग करके जवाब तैयार करता है।
NVIDIA के अनुसार training और inference AI systems के दो अलग operational phases हैं—training में model सीखता है, जबकि inference में वह learned capabilities को नए inputs पर लागू करता है। (NVIDIA)
AI हर बातचीत से तुरंत क्यों नहीं सीखता?
लोग अक्सर सोचते हैं कि AI chatbot से बात करने के बाद वह हमेशा के लिए नई जानकारी सीख लेता है।
यह जरूरी नहीं है।
किसी model का किसी user के साथ conversation करना और model का permanent training प्राप्त करना दो अलग प्रक्रियाएं हैं।
किसी AI system में memory features हो सकते हैं, लेकिन वह traditional model training से अलग हो सकता है।
एक बड़े AI model को permanent रूप से update करने के लिए आमतौर पर अलग training या post-training processes की जरूरत होती है।
यही कारण है कि AI का “सीखना” हमेशा इंसान के रोजमर्रा के सीखने जैसा नहीं होता है।
क्या AI वास्तव में समझता है?
यह आज भी सबसे बड़े वैज्ञानिक और दार्शनिक सवालों में से एक है।
AI कई कठिन काम कर सकता है।
वह कविता लिख सकता है।
Programming कर सकता है।
भाषाओं का अनुवाद कर सकता है।
कभी-कभी जटिल scientific information को भी सरल भाषा में समझा सकता है।
लेकिन क्या इसका मतलब है कि AI इंसान की तरह समझता है?
इस सवाल का सीधा जवाब देना मुश्किल है।
आज के AI systems मुख्य रूप से patterns और statistical relationships पर आधारित हैं। वे impressive results दे सकते हैं, लेकिन उनमें common sense, real-world understanding और reasoning की सीमाएं अभी भी मौजूद हैं।
Stanford AI Index 2025 ने भी यह रेखांकित किया कि advanced AI models कई demanding benchmarks पर बेहतर हुए हैं, लेकिन complex reasoning वाले कार्यों में reliability अब भी चुनौती बनी हुई है। (Stanford HAI)
यही कारण है कि AI का अच्छा जवाब हमेशा सही जवाब नहीं होता।
AI कभी-कभी गलत जानकारी क्यों देता है?
इसे आम भाषा में AI hallucination कहा जाता है।
मान लीजिए AI के पास किसी सवाल का निश्चित उत्तर नहीं है।
फिर भी वह language patterns के आधार पर ऐसा जवाब बना सकता है जो पढ़ने में बिल्कुल विश्वसनीय लगे।
लेकिन उसमें तथ्य गलत हो सकते हैं।
AI के लिए fluent sentence बनाना और factual truth सुनिश्चित करना अलग बातें हैं।
यही वजह है कि medical, legal, scientific और financial information में AI-generated content को बिना verification के स्वीकार करना जोखिमपूर्ण हो सकता है।
AI को information का अंतिम स्रोत नहीं, बल्कि कई स्थितियों में एक शक्तिशाली सहायक के रूप में देखना अधिक उचित है।
आज AI पहले से तेज़ी से क्यों सीख रहा है?
AI की प्रगति के पीछे तीन बड़े कारण हैं—डेटा, computing power और बेहतर algorithms।
पहले शक्तिशाली AI models को train करना बहुत महंगा और कठिन था।
आज GPUs और specialized AI hardware ने large-scale calculations को तेज किया है।
Stanford HAI के 2025 AI Index के अनुसार notable AI models के training compute की मांग तेजी से बढ़ी है। Report ने यह भी बताया कि AI models को चलाने की लागत में पिछले कुछ वर्षों में भारी कमी आई है, जिससे advanced AI अधिक accessible होता जा रहा है। (Stanford HAI)
2026 AI Index के अनुसार global AI compute capacity 2022 के बाद तेज गति से बढ़ी है और training के साथ-साथ inference infrastructure का महत्व भी लगातार बढ़ रहा है। (Stanford HAI)
इसका अर्थ यह है कि AI का भविष्य केवल “बड़े models” बनाने तक सीमित नहीं रहेगा। बेहतर data, efficient models और smarter training techniques भी उतनी ही महत्वपूर्ण होते जा रहे हैं।
भविष्य में AI कैसे सीखेगा?
AI research अब केवल ज्यादा data और ज्यादा powerful computers पर निर्भर रहने की कोशिश नहीं कर रही है।
Researchers ऐसे models विकसित करने पर भी काम कर रहे हैं जो कम data और कम energy में बेहतर प्रदर्शन कर सकें।
Small language models, multimodal AI, synthetic data, reasoning systems और AI agents जैसे क्षेत्रों में तेजी से research हो रही है।
Multimodal AI text के साथ images, audio और video जैसी अलग-अलग information को process कर सकता है।
भविष्य के systems संभवतः केवल भाषा के patterns पर निर्भर नहीं होंगे। वे environment से information लेकर, tools का उपयोग करके और feedback के आधार पर बेहतर decisions लेने में सक्षम हो सकते हैं।
लेकिन एक चुनौती हमेशा बनी रहेगी—AI जितना शक्तिशाली होगा, उसकी reliability और safety उतनी ही महत्वपूर्ण होगी।
निष्कर्ष
Artificial Intelligence किसी जादू से नहीं सीखता।
उसकी learning के पीछे mathematics, statistics, data और enormous computing power काम करती है।
उसे examples दिए जाते हैं।
वह patterns खोजता है।
Prediction करता है।
अपनी गलती मापता है।
फिर अपने parameters में बदलाव करता है।
यही प्रक्रिया बार-बार दोहराई जाती है।
आज के advanced AI systems इसी बुनियादी सिद्धांत को unimaginable scale पर इस्तेमाल कर रहे हैं।
लेकिन AI की सबसे प्रभावशाली क्षमता के बावजूद उसकी सीमाओं को समझना भी उतना ही जरूरी है। AI भाषा को शानदार ढंग से संभाल सकता है, patterns पहचान सकता है और कई कठिन काम कर सकता है, लेकिन वह हर बात को इंसान की तरह नहीं समझता और न ही हर उत्तर सही होता है।
शायद AI को समझने का सबसे अच्छा तरीका यही है कि उसे एक ऐसी मशीन के रूप में देखा जाए जो विशाल मात्रा में जानकारी से patterns सीख सकती है, लेकिन जिसके पास अपनी मानवीय चेतना, अनुभव या समझ नहीं है।
और यही अंतर AI को जितना शक्तिशाली बनाता है, उतना ही सावधानी से इस्तेमाल करने की जरूरत भी पैदा करता है।
अक्सर पूछे जाने वाले प्रश्न (FAQs)
1. क्या AI इंसानों की तरह हर बातचीत से तुरंत नई चीजें सीख लेता है?
नहीं। जब आप ChatGPT या किसी अन्य AI टूल से बात करते हैं, तो वह ‘Inference’ मोड में काम कर रहा होता है। इसका मतलब है कि वह अपनी पुरानी ट्रेनिंग के आधार पर तुरंत जवाब तैयार करता है। उस बातचीत को मॉडल के स्थायी ज्ञान का हिस्सा बनाने के लिए डेवलपर्स द्वारा अलग से डेटा क्लीनिंग, फाइन-ट्यूनिंग और री-ट्रेनिंग की जरूरत होती है।
2. Artificial Intelligence और सामान्य कोडिंग (Traditional Programming) में क्या फर्क है?
पारंपरिक कोडिंग में इंसान कंप्यूटर को हर स्थिति के लिए सख्त नियम (Rules) लिखकर देता है—जैसे “अगर A हो, तो B करो”। इसके विपरीत, AI (विशेषकर Machine Learning) में कंप्यूटर को नियम नहीं, बल्कि हजारों-लाखों उदाहरण (Data) दिए जाते हैं। सिस्टम खुद उन उदाहरणों में पैटर्न ढूंढकर नियम समझता है।
3. AI Hallucination क्या होता है और यह क्यों होता है?
जब AI के पास किसी सवाल का सटीक तथ्यात्मक उत्तर नहीं होता, फिर भी वह भाषा के गणितीय पैटर्न के आधार पर ऐसा जवाब बना देता है जो पढ़ने में बिल्कुल सही लगे, लेकिन उसमें तथ्य गलत हों। इसे AI Hallucination कहते हैं। AI भाषा का प्रवाह (fluency) तो बना लेता है, पर वह हमेशा सच्चाई की पुष्टि नहीं कर पाता।
4. Neural Networks क्या हैं और इनका दिमाग से क्या संबंध है?
Neural Networks कंप्यूटर एल्गोरिदम का एक गणितीय ढांचा है, जो मानव मस्तिष्क के न्यूरॉन्स के काम करने के तरीके से प्रेरित है। हालाँकि, यह इंसानी दिमाग की तरह जीवित तंत्र नहीं है, बल्कि संख्याओं, परतों (layers) और वेट्स (weights) का एक कैलकुलेशन नेटवर्क है जो इनपुट डेटा को प्रोसेस करके आउटपुट या प्रेडिक्शन देता है।
Also Read: – क्या AI सच में इंसानों की नौकरियां ले लेगा?
How Does a QR Code Store So Much Information in Such a Small Square?
📚 Verified Research Sources & Fact-Checking Citations
At FactFrontier, every claim is cross-referenced with primary scientific databases, institutional research archives, and verified historical records:
- IEEE Xplore Digital Library: Peer-reviewed computing, telecommunications, and sensor architectures.
- ACM (Association for Computing Machinery): Foundational computer science and network engineering archives.
- MIT Technology Review & Standards Laboratories: Emerging hardware and software benchmark assessments.